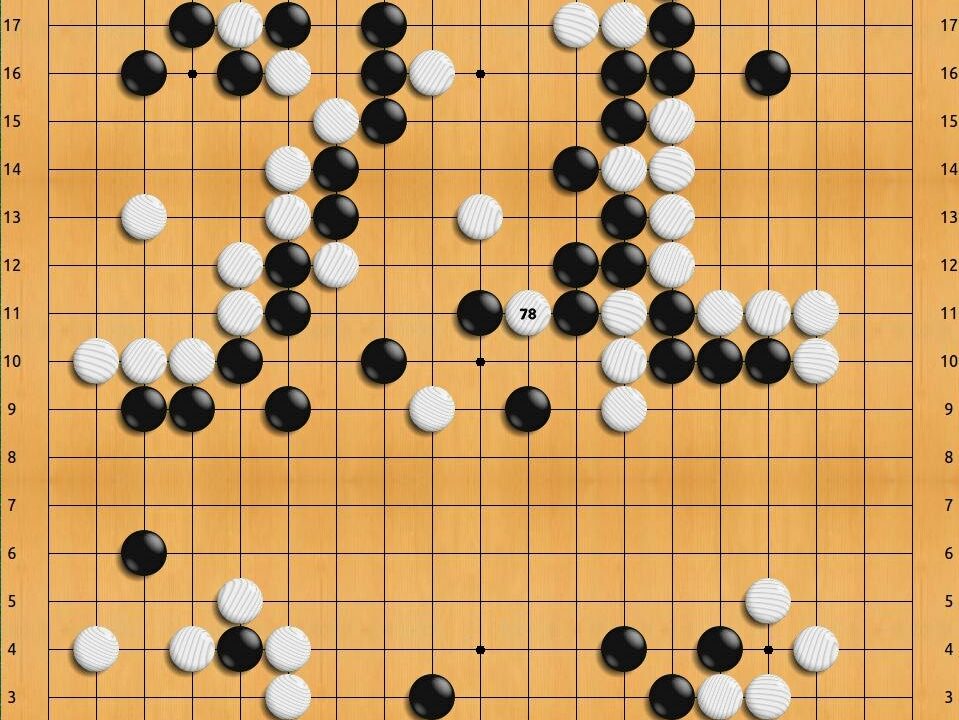
Go ma więcej możliwych pozycji niż szachy o wiele rzędów wielkości, a dobra gra wymaga intuicji. Dlatego zwycięstwo programu AlphaGo firmy DeepMind (należącej do Google) nad jednym z najlepszych graczy świata, Lee Sedolem, w marcu 2016 roku w Seulu było szokiem.
AlphaGo łączył sieci neuronowe z uczeniem przez granie z samym sobą. Słynny „ruch 37” w drugiej partii — początkowo uznany przez komentatorów za błąd — okazał się genialny. Kolejne wersje uczyły się już bez ludzkich partii, od zera.